サイト公開時はAIクローラー対策を必ずやろう:1週間で2000回来ていたので学習用だけ断った
by yasuna
7 min read
この記事はAIエージェントと一緒に執筆しています
はじめに
漫画とキャラクターを置いている個人サイト「スヤスヤ by yasuna」を、独自ドメインの suyasuya.me で公開しました。Cloudflare Pages に載せて、検索よけ(noindex)も外したところです。
公開してから Cloudflare のダッシュボードをなんとなく見ていたら、AI Crawl Control という画面で、まだほとんど誰にも告知していないサイトに AIのクローラーが1週間で約2000回 も来ていたことが分かりました。
これだけ来ると、サーバーの置き場所によっては高額請求にもなりかねません。なので結論から言うと、AIクローラー対策はサイトを公開するときに必ずやっておくべきです。
この記事は「AIクローラーってどれを止めればいいの?」を自分のサイトで仕分けた記録です。同じく絵や漫画を個人サイトに置いている人の参考になればうれしいです。
1週間で何が来ていたか
AI Crawl Control の「Last 7 days」の表示はこんな感じでした。
| 項目 | 数 |
|---|---|
| AIクローラーからのリクエスト | 1.96k |
| そのうち GPTBot(OpenAI) | 778 |
| OpenAI のクローラーが持っていった画像 | 27.98 MB |
| HTTP 200(ちゃんと中身を返した) | 1.94k |
| 失敗したリクエスト | 23 |
いちばん読まれていたのはトップページ(suyasuya.me/)でした。
27.98MB の画像というのは、ブッダの4コマ漫画やキャラクターの立ち絵です。1枚あたり数十KBの webp なので、けっこうな枚数が持っていかれている計算になります。
ちなみに、この時点ではまだ robots.txt を置いていませんでした。何も言っていないので、全部素通り(Allowed)です。
AIクローラーの何がこわいの?
最初、「脅威」と言われてもピンと来ませんでした。サイトが壊れるわけでも、パスワードが抜かれるわけでもないので。
よく言われるのは「絵や文章が学習に使われる」ことです。これは人によって考え方が分かれるところなので、ここでは置いておきます。
それとは別に引っかかったのは、持っていくだけで、人を連れてきてくれないことでした。
AIが中身を読んで答えると、読んだ人はサイトを開かなくて済みます。ページを見てもらえない、本屋(BOOTH)にも来てもらえない。27.98MB 持っていかれても、スヤスヤに1人も来ないなら、こちらには何も残りません。
逆に言うと、読んだうえで「ここに載ってるよ」とリンクで紹介してくれるなら大歓迎です。
いちばんこわいのは請求書
そしてもうひとつ、公開するならこれが一番大事です。クローラーの通信量は、そのままサーバー代になります。
スヤスヤは Cloudflare Pages に置いているので、転送量で課金されることはありません。今回の 27.98MB も、お財布には響いていません。
でも、転送量や実行回数で課金される置き場所(従量課金のクラウドやホスティング)だったら話は別です。AIのクローラーは、人間の読者とちがってページも画像も片っ端から、何度でも取りに来ます。告知もしていない段階で1週間2000回です。サイトが育って画像や動画が増えれば、その分だけ請求が膨らみます。気づいたときには、読者より AI に払ったお金の方が多かった、はふつうに起こりえます。
なので、公開する日に次の3つは済ませておくのがおすすめです。
- robots.txt で学習用クローラーを断る
- ホスティングやCDN側でもブロックする(robots.txt はお願いなので)
- 従量課金なら、予算アラートや上限を設定する
ブッダの4コマにも、ちょうどこんな回があります。毒矢が刺さったのに「誰が射たのか、弓は何でできているのか」が全部分かるまで抜かせない人の話です。
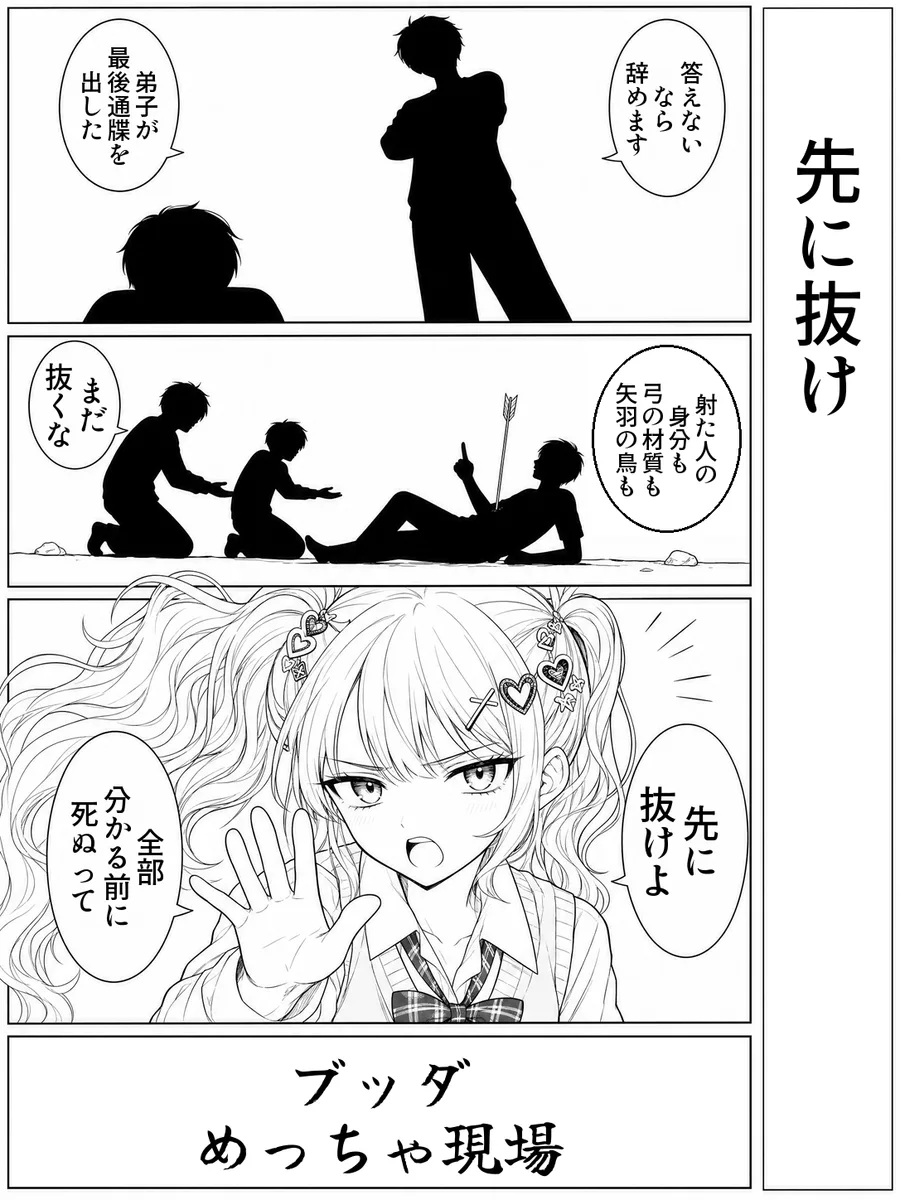
クローラーも同じで、どれが何者かを全部調べ終わるのを待っていたら、そのあいだにも請求は積み上がります。仕分けはこのあとやるとして、まずは公開の日に抜いておく。
この4コマはスヤスヤで読めます → ブッダめっちゃロジカル「先に抜け」
全部止めない:学習用だけ断ってAI検索は通す
そこで全部止めようとしたのですが、ここで一回立ち止まりました。
AIクローラーには、ざっくり2種類あります。
| 種類 | 何をするか | 例 |
|---|---|---|
| 学習・収集用 | 持っていって、学習データにする | GPTBot、ClaudeBot、CCBot、Bytespider |
| AI検索用 | 質問に答えるときに読んで、リンクで紹介する | OAI-SearchBot、ChatGPT-User、PerplexityBot、Claude-SearchBot |
AI検索用はまさに「紹介してくれる」側です。ここまで止めると、ChatGPT検索や Perplexity で「ブッダの4コマ漫画ってある?」と聞かれても、スヤスヤは出てきません。これはもったいない。
なので方針はこうしました。
- 学習・収集用 → 断る(持っていくだけなので)
- AI検索用 → 通す(紹介してくれるならうれしい)
- Googlebot・Bingbot などのふつうの検索 → 通す
robots.txt
まずは robots.txt です。いまのスヤスヤの中身はこれです(一部省略)。
# --- 学習・収集用:お断り ---
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: anthropic-ai
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
User-agent: Bytespider
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: cohere-ai
# …ほか10種
Disallow: /

# --- AI検索:歓迎 ---
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Perplexity-User
User-agent: DuckAssistBot
Allow: /

# --- ふつうの検索エンジンなど ---
User-agent: *
Allow: /

Sitemap: https://suyasuya.me/sitemap.xml
学習用20種、AI検索用9種を並べました。
ポイントは Google-Extended です。これは Google の AI の学習に使っていいかどうかの目印で、ここで止めても Googlebot(ふつうの検索)には影響しません。Google 検索には出したいけど Gemini の学習には使われたくない、が両立できます。
robots.txt は「お願い」でしかない
ただし robots.txt は、あくまでお願いです。守らないクローラーには効きません。
そこで Cloudflare の AI Crawl Control 側でも、同じ仕分けで入口から止めることにしました。一覧に出てきたクローラーは、こう分けます。
Block(学習・収集用)
- GPTBot、ClaudeBot、CCBot
- Bytespider、TikTok Spider(ByteDance)
- Meta-ExternalAgent、FacebookBot(Meta)
- Amazonbot、Google-CloudVertexBot
- Novellum AI Crawl、ProRataInc、Terracotta Bot、Timpibot
Allow のまま
- ふつうの検索:Googlebot、BingBot、Applebot、Baidu、PetalBot
- AI検索:OAI-SearchBot、ChatGPT-User、Claude-SearchBot、Claude-User、PerplexityBot、Perplexity-User、DuckAssistBot、MistralAI-User
- 人に頼まれて1ページだけ読むもの:Meta-ExternalFetcher、Manus Bot、Anchor Browser
- ウェブの保存:archive.org_bot、Arquivo Web Crawler、Cloudflare Crawler
Googlebot だけは絶対に Block しないのが大事です。ここを止めると Google 検索から消えます。
ちなみに、Security の画面にある Bot Fight Mode は別物でした。これは怪しいボットにチャレンジを出す機能で、AIクローラーの仕分けとは関係ありません。オンのままで大丈夫です。
ついでに:noindex を外して sitemap を出した
AIは断ったので、今度はふつうの検索には見つけてもらいたい。
スヤスヤは自作の個人サイトエンジン futon で動いているので、エンジン側に「干す(ビルドする)ときに sitemap.xml を書き出す」機能を足しました。site.json に公開URLが入っていて noindex でなければ、全ページを並べた sitemap.xml ができます。伏せている回は入りません。
https://github.com/YasunaCoffee/futon
robots.txt の最後の Sitemap: 行は、この sitemap.xml の場所を検索エンジンに教えるためのものです。
futon なら最初から入っています
「公開するときに必ずやる」なら、忘れないようにエンジンに入れてしまえばいい。ということで、futon 0.5.0 から 干すたびに robots.txt を自動で書き出すようにしました。
- AI の学習・収集用クローラーは断る
- AI 検索(リンクで紹介するもの)とふつうの検索は通す
site.jsonに公開URLがあればSitemap:行も付く- 自分で
public/robots.txtを置けばそちらが優先。全部通したいならsite.jsonに"aiCrawlers": "allow"
なので、futon でサイトを作れば何も書かなくても公開初日から対策済みです。雛形の AI 向け手順書(AGENTS.md)にも「公開する前に」として、Cloudflare 側のブロックと予算アラートのことを書いておきました。
npm create futon@latest my-site
8種のきせかえはここで試せます。
まとめ
- 告知していない個人サイトにも、AIクローラーは1週間で約2000回来ていた
- 困るのは攻撃ではなく、持っていくだけで人を連れてこないことと、従量課金だと請求が膨らむこと
- だからサイト公開時に必ずやる(futon なら最初から入っている)
- 学習用は断って、AI検索とふつうの検索は通すのがちょうどよかった
- robots.txt はお願いなので、Cloudflare 側でも止める
- Google の学習だけ止めたいなら Google-Extended。Googlebot は止めない
数日たったら AI Crawl Control の数字がどう変わったか、また見てみます。Blocked が増えていれば効いているはず!
ちなみにこの記事は Claude と一緒に書きました。ClaudeBot はしっかり Block しています。
スヤスヤの漫画はこちらからどうぞ。